Anthropic обрала Accenture «незалежним оцінювачем» безпеки ШІ, фінансуючи її власні перевірки
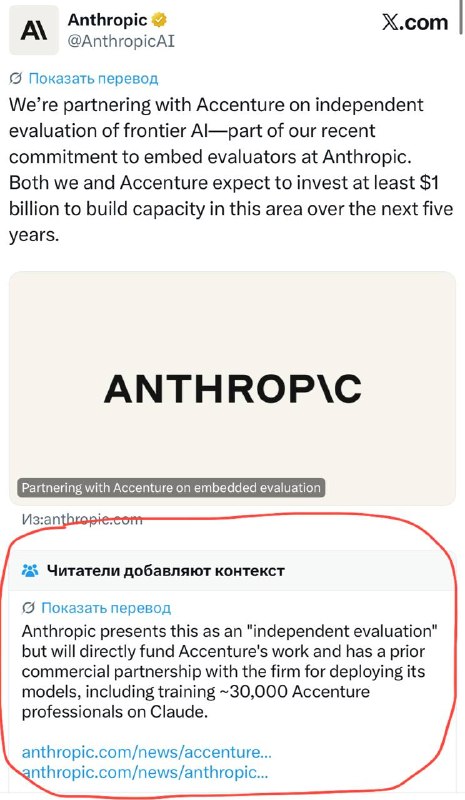
Anthropic представила Accenture як незалежного оцінювача безпеки своїх моделей, хоча компанія фінансується самою Anthropic та має з нею багаторічні контракти.
Anthropic обрала Accenture «незалежним оцінювачем» безпеки ШІ, фінансуючи її власні перевірки
Компанія Anthropic представила першого «незалежного оцінювача» в рамках програми Embedded Evaluators, яку раніше анонсував Даріо Амодеї у своєму есе про необхідність уповільнення розвитку штучного інтелекту.
Цією компанією стала Accenture. Її завдання — проводити:
- Red-teaming (пошук вразливостей);
- Перевірки вирівнювання (alignment);
- Тестування систем захисту (safeguards) моделей Claude.
Однак статус «незалежності» Accenture викликає серйозні сумніви з кількох причин:
- Accenture навчає близько 30 000 своїх співробітників роботі з Claude.
- Компанії мають багаторічний контракт, укладений ще наприкінці 2025 року.
- Anthropic прямо заявляє, що сама фінансуватиме роботу Accenture у цій сфері.
Це нагадує попередню ситуацію з організацією METR, яка отримала від Anthropic «незалежний доступ» для розслідування інцидентів з агентами, попри те, що METR також фінансово залежить від акцій стартапу.
В підсумку: Anthropic декларує залучення незалежних експертів, але обирає їх зі сфери своїх ділових партнерів, яких фінансує сама платформа.
Чому це важливо
АналітикаСитуація ставить під сумнів об'єктивність оцінок безпеки ШІ, коли «незалежні» аудитори фінансуються безпосередньо розробниками моделей, створюючи конфлікт інтересів.
Обговорити новину у спільноті
Діліться своїм досвідом та думками з ШІ-розробниками
Пов'язані матеріали екосистеми
Практичні гайди, термінологія та агентські скіли
Проблема вирівнювання ШІ (AI Alignment)
Фундаментальна проблема безпеки штучного інтелекту: узгодження цілей та мотивації автономних систем із людськими цінностями, етикою та збереженням життя. Досліджує ризики того, що надрозумна система знайде буквальний або деструктивний шлях виконання нечітко поставленого завдання.
Машинне забування (Machine Unlearning)
Технологія хірургічного видалення конкретних знань, приватних даних користувачів або матеріалів з обмеженим копірайтом із ваг уже навченої нейромережі. Дозволяє компаніям виконувати вимоги закону про «право на забуття» (GDPR) без катастрофічно дорогого повного перетренування моделі.
Claude відхилив запит через слово «cyber»
Коротке спостереження про те, що Claude відхилив запит через слово «cyber».
Сервіс для оцінки ризику блокування з боку Anthropic
Китайські розробники запустили сервіс, який аналізує IP-адресу, країну, провайдера, тип підключення, а також перевіряє витоки DNS і WebRTC, щоб оцінити ризик отримання блокування від Anthropic.