# Format CSV: Kompletny przewodnik po automatyzacji i pracy z AI
> Praktyczny poradnik dotyczący wykorzystania formatu CSV w potokach AI: specyfikacja RFC 4180, porównanie z XLSX i JSON, masowe czyszczenie i wzbogacanie danych, kodowanie w Pythonie oraz gotowe prompty.
## 1. Czym jest format CSV: anatomia, specyfikacja RFC 4180 i struktura danych
**CSV** (*Comma-Separated Values*) to najpopularniejszy na świecie otwarty format tekstowy służący do przechowywania i wymiany dwuwymiarowych danych tabelarycznych. Jego oficjalna specyfikacja została ustandaryzowana w dokumencie IETF RFC 4180.
Z natury plik CSV jest zwykłym plikiem tekstowym pozbawionym formatowania graficznego: każdy wiersz pliku odpowiada jednemu wierszowi tabeli (rekordowi), a wartości kolumn są oddzielone przecinkami. Zazwyczaj pierwszy wiersz zarezerwowany jest dla nagłówków kolumn.
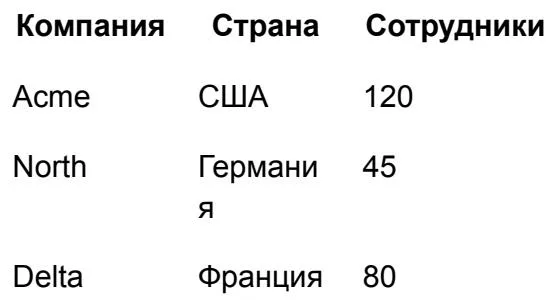
```csv
Компанія,Країна,Співробітники
Acme,США,120
North,Німеччина,45
Delta,Франція,80
```
### Fundamentalne zasady formatowania zgodne z RFC 4180
1. **Separatory wierszy:** Każdy rekord znajduje się w osobnym wierszu i kończy się znakiem nowej linii (`CRLF` lub `LF`).
2. **Obowiązkowe cudzysłowy:** Jeśli wartość komórki zawiera przecinek, znak nowej linii lub podwójny cudzysłów, cała wartość musi być bezwzględnie objęta podwójnymi cudzysłowami: `"Kijów, Ukraina"`.
3. **Eskapowanie cudzysłowów:** Wewnętrzne cudzysłowy w tekście są escapowane poprzez ich podwojenie: `"Sp. z o.o. ""Technologies of the Future"""`.
4. **Równa liczba kolumn:** Każdy wiersz musi zawierać dokładnie taką samą liczbę pól jak pierwszy wiersz nagłówków.
> [!NOTE]
> CSV przechowuje wyłącznie czyste wartości. Nie zawiera informacji o fontach, kolorach komórek, szerokości kolumn ani formułach. To właśnie ta prostota czyni z CSV uniwersalny most łączący modele AI, bazy danych i usługi biznesowe.
---
## 2. Dlaczego CSV jest najbardziej efektywnym formatem dla LLM i agentów AI
Nowoczesne duże modele językowe (GPT-4o, Claude 3.5 Sonnet, Gemini 1.5 Pro) równie skutecznie przetwarzają zarówno dane w formacie CSV, jak i XLSX. Jednak w inżynieryjnych pipeline’ach oraz systemach agentowych to właśnie CSV stanowi domyślny standard.
```mermaid
flowchart LR
A["Сирий неструктурований текст
(Відгуки, ліди, описи)"] --> B["LLM / AI-агент
(Парсинг сутностей)"]
B -->|Генерація плоского потоку| C["Потік даних CSV
(Мінімальна витрата токенів)"]
C --> D["Бази даних SQL / NoSQL
(Миттєвий bulk import)"]
C --> E["CRM / BI Дашборди
(HubSpot, Tableau, Sheets)"]
```
### Główne zalety CSV dla systemów sztucznej inteligencji
- **Ekstremalna oszczędność tokenów:** W przeciwieństwie do formatu XLSX (który jest skompresowanym archiwum ZIP zawierającym dziesiątki plików XML) czy JSON (gdzie każda nazwa pola jest duplikowana dla każdego obiektu), CSV przesyła nazwy pól tylko raz, w nagłówku.
- **Niskie obciążenie poznawcze kontekstu:** Modelom znacznie łatwiej orientować się w tabeli pozbawionej szumu XML, tagów technicznych oraz metadanych stylu.
- **Wsparcie dla przesyłania strumieniowego (Streaming):** AI może generować wiersze CSV jeden po drugim w czasie rzeczywistym, umożliwiając przetwarzanie milionów rekordów partiami (chunks) bez ładowania całego dokumentu do pamięci.
- **Idealna kompatybilność z Code Interpreter:** Środowiska wykonujące kod w ChatGPT lub Claude natychmiast odczytują CSV jednym wywołaniem `pandas.read_csv()`.
---
## 3. Analiza porównawcza: CSV vs XLSX i JSON
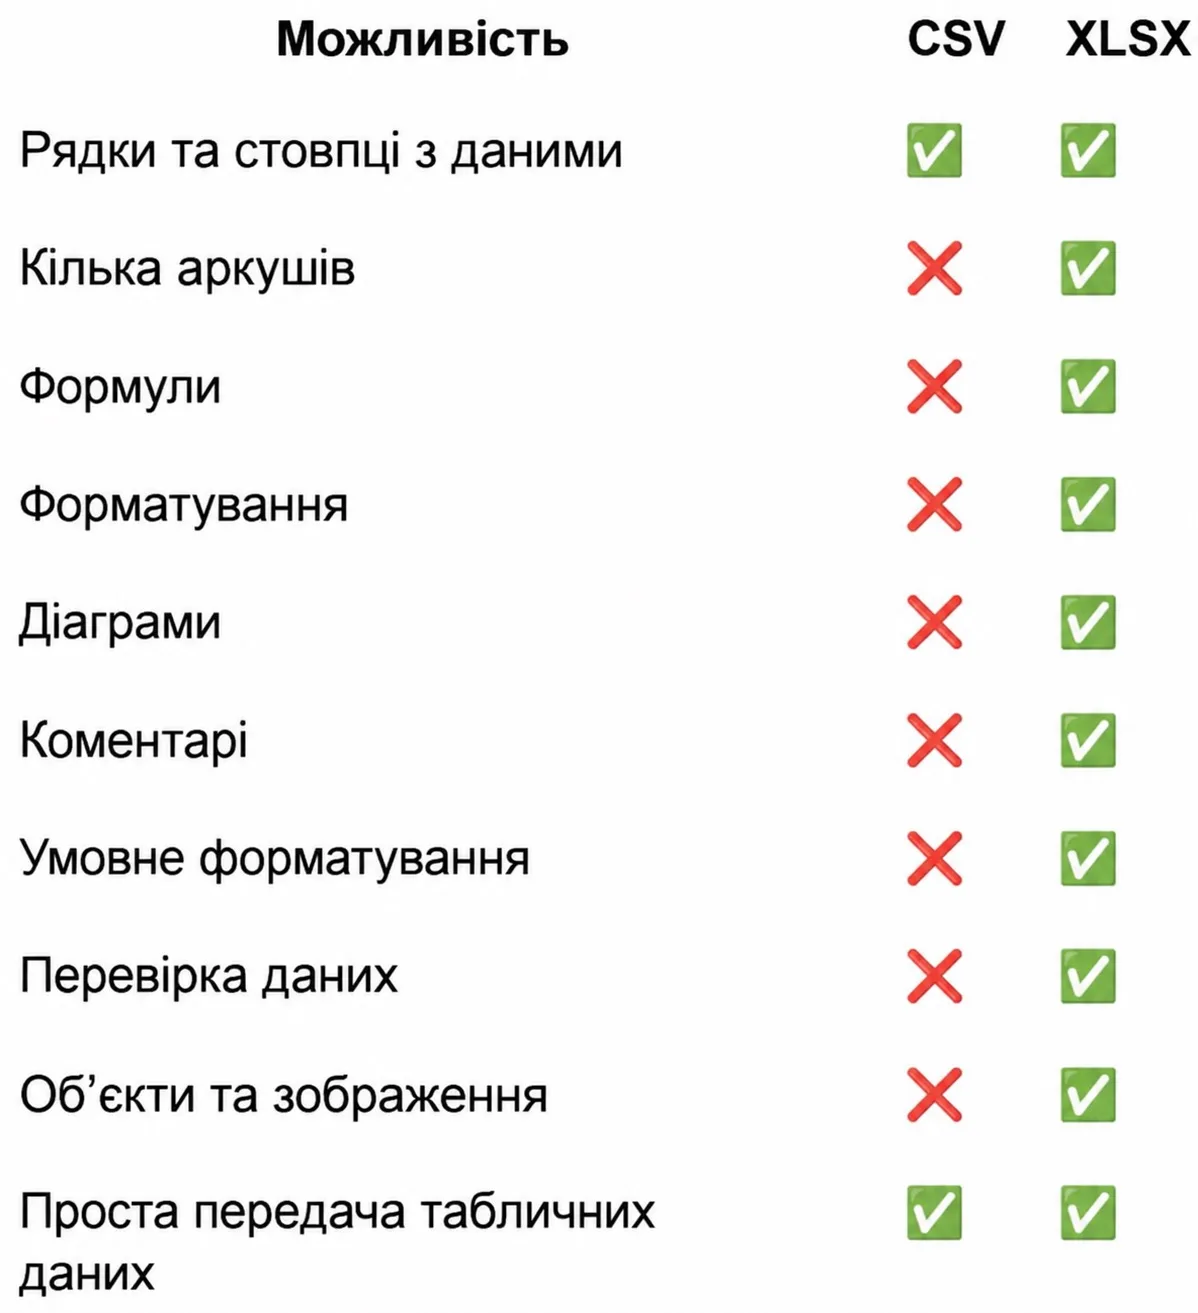
Wybór formatu zależy od tego, czy potrzebujesz wyłącznie „surowych” danych, pełnoprawnego skoroszytu z formułami, czy też złożonej hierarchii zagnieżdżonej.
| Możliwość i kryterium | CSV | XLSX (Excel) | JSON |
| :--- | :--- | :--- | :--- |
| **Wiersze i kolumny z danymi** | ✓ Tak | ✓ Tak | Wymaga normalizacji |
| **Wiele nazwanych arkuszy** | ✗ Nie (tylko 1 arkusz) | ✓ Tak | ✓ Poprzez tablice zagnieżdżone |
| **Formuły obliczeniowe** | ✗ Nie | ✓ Tak (żywe formuły) | ✗ Nie |
| **Formatowanie i stylizacja** | ✗ Nie | ✓ Tak (kolory, fonty) | ✗ Nie |
| **Zagnieżdżone struktury hierarchiczne** | ✗ Trudno (dane płaskie) | ✗ Ograniczone | ✓ Idealnie (struktury drzewiaste) |
| **Oszczędność tokenów dla AI** | ⭐ Najwyższa | ⚠️ Niska (narzut XML) | 🟡 Średnia (powtarzanie kluczy) |
| **Bezpośredni import do CRM / SQL** | ✓ Jednym kliknięciem | ⚠️ Wymaga konwersji | ⚠️ Wymaga mapowania |
> [!TIP]
> Jeśli Twoim celem jest przesłanie tablicy produktów do klasyfikacji lub eksport bazy leadów do wysyłki newslettera, użyj CSV. Natomiast jeśli musisz dostarczyć inwestorowi model finansowy z podsumowaniami obliczeń – pozostań przy XLSX.
---
## 4. Typowe pułapki składni CSV: separatory, cudzysłowy i kodowanie UTF-8
Choć format wydaje się prymitywny, w praktyce ponad 70% błędów automatyzacji wynika z trzech niuansów technicznych.
### Konflikt przecinka i średnika (Lokalizacja Excela)
W krajach Europy i obszaru postsowieckiego separatorem dziesiętnym w liczbach jest przecinek (`12,50`). Z tego powodu europejskie wersje Microsoft Excel domyślnie eksportują CSV, używając jako separatora kolumn średnika (`;`), a nie przecinka (`,`).
- Jeśli AI oczekuje przecinka, a otrzymuje średnik – cała tabela scalona zostanie w jedną gigantyczną kolumnę.
- Zawsze jawnie wskazuj systemowi separator: *„Używaj standardowego przecinka jako separatora kolumn”*.
### Znaki nowej linii wewnątrz komórki
Jeśli komórka z opisem zawiera kilka akapitów, niepoprawny parser potraktuje każdy akapit jako nowy rekord tabeli. Zgodnie ze standardem RFC 4180 takie pola muszą być zamknięte w podwójnych cudzysłowach:
```csv
ID,Назва,Опис
101,Ноутбук,"Потужний процесор.
Гарантія 24 місяці."
```
### Pułapka kodowania UTF-8 i znacznik BOM
Podczas otwierania pliku CSV z cyrylicą w programie Excel zamiast tekstu często pojawiają się „krzaczki”. Przyczyną jest brak sygnatury **BOM** (*Byte Order Mark* – bajty `EF BB BF`).
- Do importu do nowoczesnych baz danych i usług AI stosuj czysty **UTF-8 without BOM**.
- Aby zagwarantować poprawne otwarcie w desktopowym Microsoft Excel na Windows, zapisuj plik jako **UTF-8 with BOM**.
---
## 5. Przygotowanie CSV dla AI: zasady czystości i higieny danych
Im wyższa jakość wejściowego pliku CSV, tym dokładniejsze będą wnioski analityczne i transformacje przeprowadzane przez model językowy.
```mermaid
flowchart TD
subgraph Hygiene_Rules["5 Золотих Правил Гігієни CSV"]
R1["1. Семантичні назви стовпців
(Company замість Column_1)"]
R2["2. Атомарність полів
(Окремо Name та Email)"]
R3["3. Безперервність масиву
(Жодних порожніх розділових рядків)"]
R4["4. Канонічні типи даних
(ISO дати YYYY-MM-DD, чисті числа)"]
R5["5. Один рядок — один об'єкт
(Заборона злиття різних сутностей)"]
end
```
### Przed i po obróbce sanitarnej
:::tabs
@tab Zaśmiecony CSV (Źle)
```csv
Звіт за травень 2026,,,
Компанія,Інформація,Сума
ТОВ Вектор,"Київ, Іван, тел: 0501112233",5000 грн
ПП Альфа,Одеса; Петро,12000 $
```
*Problemy:* Nadmiarowy wiersz nagłówka, pusty wiersz separatora, mieszane waluty, zmieszane informacje kontaktowe w jednej kolumnie.
@tab Wyczyszczony CSV (Idealny dla AI)
```csv
company_name,city,contact_person,phone,amount,currency
ТОВ Вектор,Київ,Іван,+380501112233,5000,UAH
ПП Альфа,Одеса,Петро,+380502223344,12000,USD
```
*Zalety:* Atomy pól, czyste liczby, znormalizowane kody walut, natychmiastowa czytelność dla algorytmów.
:::
---
## 6. Masowa obróbka danych: czyszczenie, wzbogacanie i klasyfikacja przez AI
Największą wartość CSV wykazuje podczas masowych transformacji realizowanych przez ChatGPT Advanced Data Analysis lub Claude Code.
### Główne scenariusze masowej automatyzacji
1. **Deduplikacja i łączenie baz:** Wykrywanie ukrytych duplikatów (np.: *«Google LLC»* oraz *«Google Polska»*), czyszczenie z nieprawidłowych adresów e-mail.
2. **Semantyczne wzbogacanie (Enrichment):** Dodawanie do istniejącej listy firm oceny ich skali, branży wg PKD lub linków do oficjalnych stron internetowych.
3. **Analiza sentymentu i kategoryzacja:** Masowa analiza 10 000 tekstowych opinii klientów z nadawaniem tagów `Sentiment` (*Positive/Neutral/Negative*) oraz `Issue_Type` (*Delivery/Billing/UX*).
4. **Normalizacja encji:** Ujednolicanie dziesiątek różnorodnych zapisów krajów (*«USA», «U.S.», «United States», «Stany Zjednoczone»*) do jednego kodu ISO `US`.
---
## 7. Kiedy CSV zdecydowanie NIE nadaje się: ograniczenia i alternatywy
CSV jest narzędziem wąsko wyspecjalizowanym. Próba wykorzystania go niezgodnie z przeznaczeniem niszczy procesy robocze.
### Cztery bariery zastosowania CSV
1. **Relacje wielopoziomowe i listy:** Jeśli jeden użytkownik ma 5 adresów dostawy, 3 karty bankowe i 20 zamówionych produktów, próba upchnięcia tego w jednym wierszu CSV spowoduje albo duplikację danych, albo nieczytelne komórki. Dla takich zadań standardem jest **JSON**.
2. **Analiza logiki formułowej:** Jeśli musisz sprawdzić, jak zmiana stawki podatku w komórce `B2` wpływa na zysk netto w `G48`, użyj **XLSX**. CSV niszczy formuły, pozostawiając jedynie utrwalone liczby.
3. **Dokumenty prezentacyjne:** Oferty handlowe, instrukcje i umowy wymagają stron tytułowych, układu stylistycznego i logo – do nich przeznaczony jest **DOCX**.
4. **Nieustrukturyzowana wiedza:** Artykułów, prac naukowych i instrukcji nie da się sprowadzić do tabel bez utraty powiązań semantycznych – do nich stosuje się **Markdown**.
---
## 8. Automatyzacja programowa: praca z CSV w Python i TypeScript
W produkcyjnych agentach AI interakcja z CSV odbywa się poprzez szybkie biblioteki, które zapobiegają przepełnieniu pamięci operacyjnej.
:::tabs
@tab Python (Pandas & Streaming)
```python
import pandas as pd
# 1. Швидке зчитування та фільтрація великого датасету
df = pd.read_csv("clients.csv", encoding="utf-8")
# Очищення від порожніх записів та фільтрація
df_cleaned = df.dropna(subset=["email"]).copy()
df_cleaned["status"] = "Active"
# 2. Потокова обробка великих файлів (>1 ГБ) частинами
chunk_size = 5000
for chunk in pd.read_csv("massive_dataset.csv", chunksize=chunk_size):
# Передача chunk у модель для пакетної класифікації
processed_chunk = chunk[chunk["revenue"] > 10000]
processed_chunk.to_csv("filtered_data.csv", mode="a", header=False, index=False)
print("Обробка успішно завершена.")
```
@tab TypeScript (Papaparse & Node.js)
```typescript
import Papa from 'papaparse';
import * as fs from 'fs';
interface ClientRecord {
company: string;
country: string;
employees: number;
priority?: string;
}
// Зчитування та парсинг файлу
const fileContent = fs.readFileSync('companies.csv', 'utf8');
Papa.parse(fileContent, {
header: true,
dynamicTyping: true,
skipEmptyLines: true,
complete: (results) => {
// Збагачення кожного рядка через AI-сервіс
const enriched = results.data.map(row => ({
...row,
priority: row.employees > 100 ? 'High' : 'Standard'
}));
// Зворотна серіалізація в CSV
const csvOutput = Papa.unparse(enriched);
fs.writeFileSync('companies_enriched.csv', csvOutput, 'utf8');
}
});
```
:::
---
## 9. Gotowa biblioteka promptów mistrzowskich do pracy z CSV
Korzystaj z tych gotowych szablonów inżynieryjnych do pracy z modelami językowymi bez utraty wierszy i struktury.
### Prompt do generowania nowej bazy od zera
```markdown
Działaj jako wiodący analityk danych. Wygeneruj realistyczny syntetyczny zestaw danych w formacie CSV.
Temat: [Podaj temat, np.: Katalog narzędzi AI do marketingu 2026]
Zakres: Dokładnie 25 unikalnych rekordów.
Wymagania dotyczące struktury:
- Kolumny: Tool_Name, Category, Pricing_Model, Target_Audience, Key_Feature, URL_Slug
- Pierwszy wiersz – obowiązkowe nagłówki w języku angielskim bez spacji.
- Jeden wiersz odpowiada dokładnie jednemu narzędziu.
- Jeśli opis zawiera przecinki, koniecznie ujmij wartość w podwójne cudzysłowy.
- Wypisz TYLKO czysty surowy kod CSV wewnątrz bloku ```csv. Żadnego tekstu wprowadzającego ani podsumowującego.
```
### Prompt do czyszczenia i wzbogacania załadowanej tabeli
```markdown
Przeanalizuj przesłany plik CSV. Twoje zadanie to audyt i wzbogacenie danych.
Instrukcje dotyczące obróbki:
1. Usuń całkowicie zdublowane wiersze.
2. Znormalizuj kolumnę Country zgodnie z międzynarodowym standardem nazw.
3. Dodaj nową kolumnę "Segment":
- "Enterprise", jeśli Employees > 250
- "Mid-Market", jeśli Employees od 50 do 250
- "SMB", jeśli Employees < 50
4. Dodaj kolumnę "Action_Plan" z krótką rekomendacją dla menedżera (do 10 słów).
5. Nie usuwaj ani nie zmieniaj kolejności wyjściowych kolumn.
Zwróć wynik w postaci kompletnego pliku CSV do pobrania.
```
---
## 10. Podsumowujący checklist walidacji i ściągawka wyboru formatu
Zanim załadujesz wygenerowany plik CSV do CRM lub wyślesz go do systemu analitycznego, przeprowadź ekspresową walidację.
### Checklist kontroli jakości CSV
- [ ] **Integralność kolumn:** Liczba przecinków w każdym wierszu zgadza się z liczbą kolumn w pierwszym wierszu nagłówków.
- [ ] **Poprawne escapowanie:** Wszystkie fragmenty tekstowe zawierające przecinki lub znaki nowej linii są zamknięte w podwójnych cudzysłowach `" "`.
- [ ] **Brak zbędnych odstępów:** Nie ma pustych wierszy separatora na początku, w środku ani na końcu pliku.
- [ ] **Kodowanie pliku:** Plik został zapisany w formacie UTF-8 (dla Excela zweryfikowano obecność BOM, jeśli wymagana).
- [ ] **Jednorodność formatów:** Daty mają jednolity standard (`YYYY-MM-DD`), ułamki dziesiętne są zapisywane z kropką.