# CSV-Format: Vollständiger Leitfaden für Automatisierung und KI-Nutzung
> Praktischer Leitfaden zur Verwendung des CSV-Formats in KI-Pipelines: RFC 4180-Spezifikation, Vergleich mit XLSX und JSON, massenhafte Datenbereinigung und -anreicherung, Python-Coding sowie fertige Prompts.
## 1. Was ist das CSV-Format: Anatomie, RFC 4180-Spezifikation und Datenstruktur
**CSV** (*Comma-Separated Values*) ist das weltweit verbreitetste offene Textformat zur Speicherung und zum Austausch zweidimensionaler tabellarischer Daten. Die offizielle Spezifikation ist im IETF-Standard RFC 4180 festgelegt.
Im Kern ist eine CSV-Datei eine einfache Textdatei ohne grafische Formatierung: Jede Zeile der Datei entspricht einer Tabellenzeile (einem Datensatz), wobei die Spaltenwerte durch Kommas getrennt werden. Üblicherweise wird die erste Zeile für die Spaltenüberschriften verwendet.
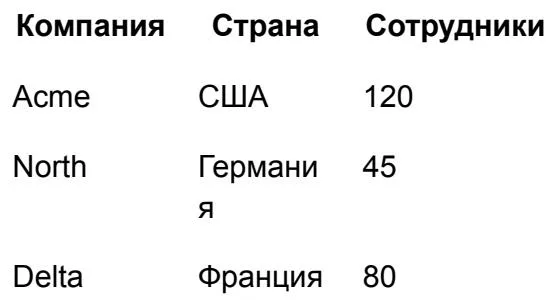
```csv
Компанія,Країна,Співробітники
Acme,США,120
North,Німеччина,45
Delta,Франція,80
```
### Grundlegende Formatierungsregeln gemäß RFC 4180
1. **Zeilenumbrüche:** Jeder Datensatz befindet sich in einer eigenen Zeile und endet mit einem Zeilenumbruch (`CRLF` oder `LF`).
2. **Pflicht-Anführungszeichen:** Wenn ein Zellwert ein Komma, ein Zeilenumbruchzeichen oder doppelte Anführungszeichen enthält, muss der gesamte Wert zwingend in doppelte Anführungszeichen gesetzt werden: `"Kiew, Ukraine"`.
3. **Maskierung von Anführungszeichen:** Innere Anführungszeichen innerhalb des Textes werden durch Verdopplung maskiert: `"GmbH ""Technologien der Zukunft"""`.
4. **Gleiche Anzahl an Spalten:** Jede Zeile muss exakt dieselbe Anzahl an Feldern enthalten wie die Kopfzeile.
> [!NOTE]
> CSV speichert ausschließlich reine Werte. Es fehlen Informationen zu Schriftarten, Zellfarben, Spaltenbreiten oder Formeln. Genau diese Einfachheit macht CSV zur universellen Brücke zwischen KI-Modellen, Datenbanken und Business-Services.
---
## 2. Warum CSV das effizienteste Format für LLMs und KI-Agenten ist
Moderne große Sprachmodelle (GPT-4o, Claude 3.5 Sonnet, Gemini 1.5 Pro) nehmen sowohl CSV als auch XLSX gleichermaßen erfolgreich wahr. In Engineering-Pipelines und Agentensystemen ist jedoch CSV der Standard-Default.
```mermaid
flowchart LR
A["Сирий неструктурований текст
(Відгуки, ліди, описи)"] --> B["LLM / AI-агент
(Парсинг сутностей)"]
B -->|Генерація плоского потоку| C["Потік даних CSV
(Мінімальна витрата токенів)"]
C --> D["Бази даних SQL / NoSQL
(Миттєвий bulk import)"]
C --> E["CRM / BI Дашборди
(HubSpot, Tableau, Sheets)"]
```
### Hauptvorteile von CSV für Künstliche Intelligenz-Systeme
- **Extreme Token-Effizienz:** Im Gegensatz zum XLSX-Format (ein gepacktes ZIP-Archiv aus Dutzenden XML-Dateien) oder JSON (wo jeder Feldname für jedes Objekt dupliziert wird), überträgt CSV die Feldnamen nur einmal im Header.
- **Geringe kognitive Last für den Kontext:** Modelle können sich deutlich leichter in Tabellen orientieren, ohne unnötiges XML-Rauschen, Service-Tags oder Stil-Metadaten.
- **Unterstützung von Streaming:** KI kann CSV zeilenweise in Echtzeit generieren, was die Verarbeitung von Millionen von Datensätzen in Chunks ermöglicht, ohne das gesamte Dokument in den Speicher laden zu müssen.
- **Ideale Kompatibilität mit Code Interpreter:** Code-Ausführungsumgebungen in ChatGPT oder Claude lesen CSV sofort mit einer einzigen Zeile via `pandas.read_csv()`.
---
## 3. Vergleichende Analyse: CSV vs. XLSX und JSON
Die Wahl des Formats hängt davon ab, ob Sie ausschließlich „nackte“ Daten benötigen oder eine vollwertige Arbeitsmappe mit Formeln bzw. eine komplexe verschachtelte Hierarchie erforderlich ist.
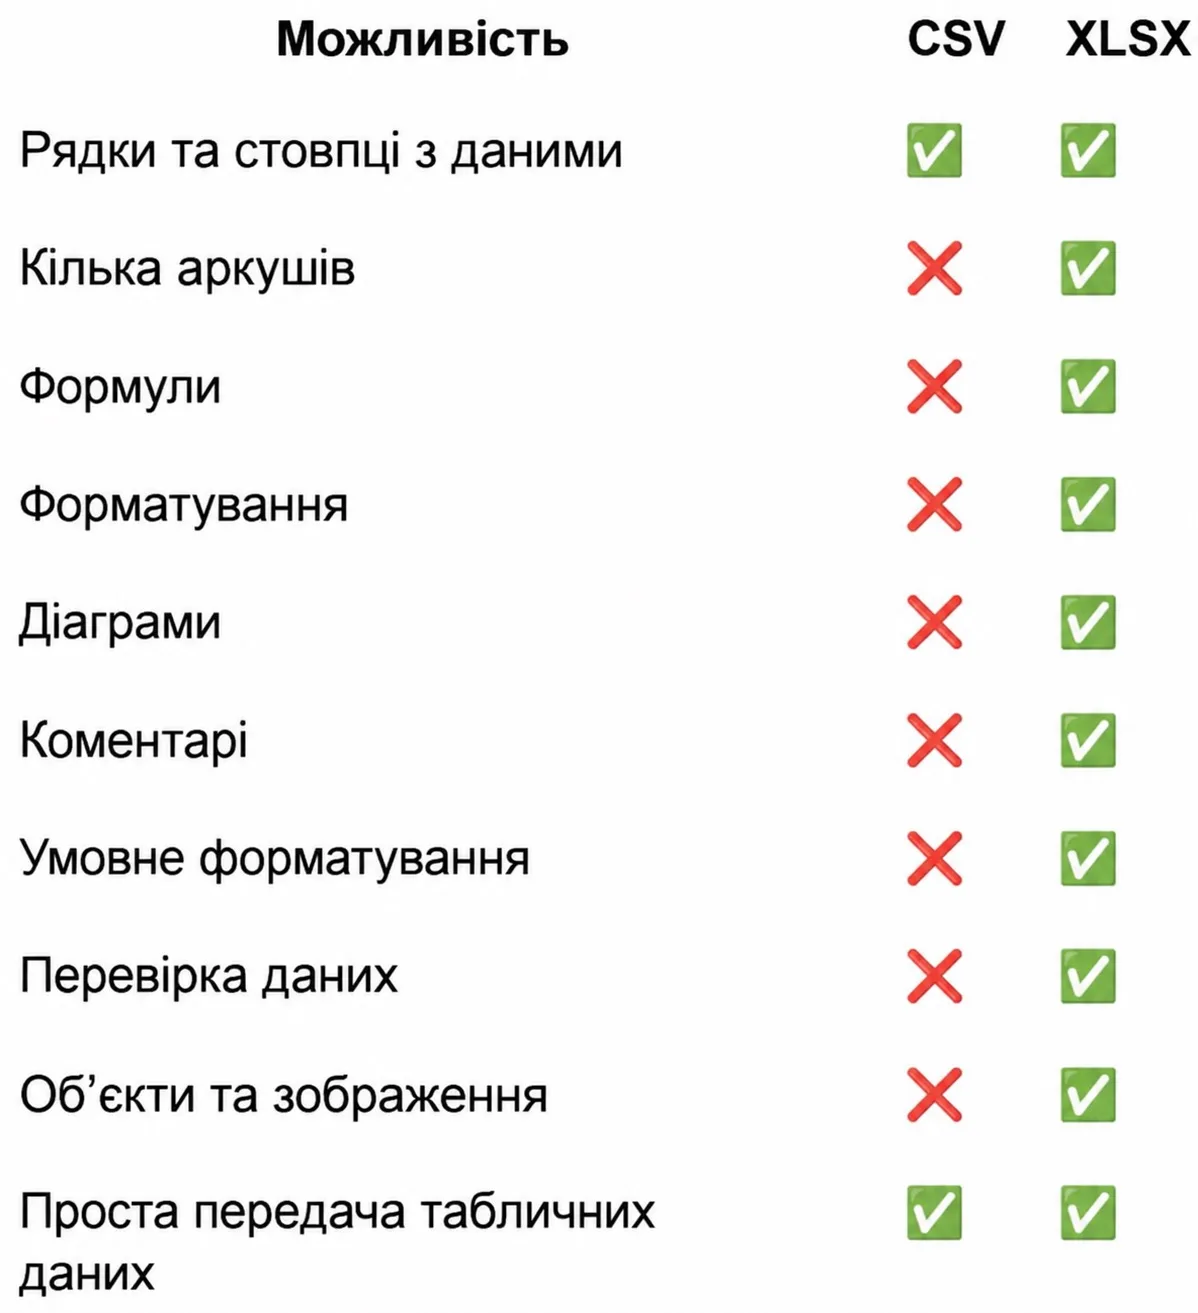
| Fähigkeit & Kriterium | CSV | XLSX (Excel) | JSON |
| :--- | :--- | :--- | :--- |
| **Datenzeilen und -spalten** | ✓ Ja | ✓ Ja | Normalisierung erforderlich |
| **Mehrere benannte Blätter** | ✗ Nein (nur 1 Blatt) | ✓ Ja | ✓ Über verschachtelte Arrays |
| **Berechnungsformeln** | ✗ Nein | ✓ Ja (lebendige Formeln) | ✗ Nein |
| **Formatierung & Styling** | ✗ Nein | ✓ Ja (Farben, Schriften) | ✗ Nein |
| **Verschachtelte hierarchische Strukturen** | ✗ Schwierig (flache Daten) | ✗ Eingeschränkt | ✓ Ideal (baumartig) |
| **Token-Effizienz für KI** | ⭐ Höchste | ⚠️ Niedrig (XML-Overhead) | 🟡 Mittel (Key-Repetition) |
| **Direkter Import in CRM / SQL** | ✓ Mit einem Klick | ⚠️ Erfordert Konvertierung | ⚠️ Erfordert Mapping |
> [!TIP]
> Wenn Ihr Ziel darin besteht, ein Produktarray zur Klassifizierung zu übermitteln oder eine Lead-Datenbank für Mailings zu exportieren, verwenden Sie CSV. Wenn Sie jedoch einem Investor ein Finanzmodell mit zusammenfassenden Berechnungen vorlegen müssen, bleiben Sie bei XLSX.
---
## 4. Typische Syntax-Fallen bei CSV: Trennzeichen, Anführungszeichen und UTF-8-Kodierung
Obwohl das Format primitiv erscheint, entstehen in der Praxis über 70 % der Automatisierungsfehler aufgrund dreier technischer Nuancen.
### Konflikt zwischen Komma und Semikolon (Excel-Lokalisierung)
In Europa und dem postsowjetischen Raum ist das Dezimaltrennzeichen in Zahlen ein Komma (`12,50`). Aus diesem Grund exportieren europäische Versionen von Microsoft Excel standardmäßig CSV unter Verwendung eines Semikolons (`;`) als Spaltentrennzeichen statt eines Kommas (`,`).
- Wenn die KI ein Komma erwartet, aber ein Semikolon erhält, verschmilzt die gesamte Tabelle zu einer einzigen riesigen Spalte.
- Geben Sie dem System immer explizit das Trennzeichen an: *„Verwende das Standardkomma als Spaltentrennzeichen“*.
### Zeilenumbrüche innerhalb einer Zelle
Wenn eine Beschreibungs-Zelle mehrere Absätze enthält, interpretiert ein inkorrekter Parser jeden Absatz als neuen Tabelleneintrag. Gemäß dem RFC 4180-Standard müssen solche Felder zwingend in doppelte Anführungszeichen eingeschlossen sein:
```csv
ID,Назва,Опис
101,Ноутбук,"Потужний процесор.
Гарантія 24 місяці."
```
### Falle UTF-8-Kodierung und BOM-Marker
Beim Öffnen einer CSV-Datei mit Kyrillisch in Excel erscheinen oft „Mojibake“-Zeichen statt Text. Die Ursache ist das Fehlen der **BOM**-Signatur (*Byte Order Mark* – Bytes `EF BB BF`).
- Für den Import in moderne Datenbanken und KI-Services verwenden Sie reines **UTF-8 without BOM**.
- Für garantiertes Öffnen im Desktop-Microsoft Excel auf Windows speichern Sie als **UTF-8 with BOM**.
---
## 5. Vorbereitung von CSV für KI: Regeln für Datenhygiene und Sauberkeit
Je hochwertiger die Eingangs-CSV-Datei formatiert ist, desto präziser sind die analytischen Schlussfolgerungen und Transformationen des Sprachmodells.
```mermaid
flowchart TD
subgraph Hygiene_Rules["5 Золотих Правил Гігієни CSV"]
R1["1. Семантичні назви стовпців
(Company замість Column_1)"]
R2["2. Атомарність полів
(Окремо Name та Email)"]
R3["3. Безперервність масиву
(Жодних порожніх розділових рядків)"]
R4["4. Канонічні типи даних
(ISO дати YYYY-MM-DD, чисті числа)"]
R5["5. Один рядок — один об'єкт
(Заборона злиття різних сутностей)"]
end
```
### Vorher und Nachher der Datenaufbereitung
:::tabs
@tab Verschmutztes CSV (Schlecht)
```csv
Звіт за травень 2026,,,
Компанія,Інформація,Сума
ТОВ Вектор,"Київ, Іван, тел: 0501112233",5000 грн
ПП Альфа,Одеса; Петро,12000 $
```
*Probleme:* Überflüssige Überschriftenzeile, leere Trennzeile, gemischte Währungen, gemischte Kontaktinformationen in einer Spalte.
@tab Bereinigtes CSV (Ideal für KI)
```csv
company_name,city,contact_person,phone,amount,currency
ТОВ Вектор,Київ,Іван,+380501112233,5000,UAH
ПП Альфа,Одеса,Петро,+380502223344,12000,USD
```
*Vorteile:* Atomare Felder, saubere Zahlen, standardisierte Währungscodes, sofortige Lesbarkeit durch Algorithmen.
:::
---
## 6. Massendatenverarbeitung: Bereinigung, Anreicherung und Klassifizierung durch KI
Den größten Mehrwert bietet CSV bei der Ausführung von Massen-Transformationen über ChatGPT Advanced Data Analysis oder Claude Code.
### Hauptszenarien der Massenautomatisierung
1. **Deduplizierung und Datenbank-Merging:** Erkennung impliziter Duplikate (z. B.: *„Google LLC“* und *„Google Ukraine“*), Bereinigung ungültiger E-Mail-Adressen.
2. **Semantische Anreicherung (Enrichment):** Hinzufügen von Einschätzungen zur Unternehmensgröße, Branchen-Codes (NACE) oder Links zur offiziellen Website zu bestehenden Firmenlisten.
3. **Sentiment-Analyse und Kategorisierung:** Massenanalyse von 10.000 Kundenbewertungen mit Tagging von `Sentiment` (*Positive/Neutral/Negative*) und `Issue_Type` (*Delivery/Billing/UX*).
4. **Entitäts-Normalisierung:** Vereinheitlichung dutzender unterschiedlicher Länderangaben (*„USA“, „U.S.“, „United States“, „USA“*) auf einen einzigen ISO-Code `US`.
---
## 7. Wann CSV kategorisch NICHT geeignet ist: Einschränkungen und Alternativen
CSV ist ein spezialisiertes Werkzeug. Der Versuch, es zweckentfremdet einzusetzen, zerstört Workflows.
### Vier Barrieren für den Einsatz von CSV
1. **Mehrstufige Beziehungen und Listen:** Wenn ein Benutzer 5 Lieferadressen, 3 Bankkarten und 20 bestellte Produkte hat, führt der Versuch, dies in eine CSV-Zeile zu pressen, entweder zu Daten-Duplizierung oder unlesbaren Zellen. Für solche Aufgaben ist **JSON** der Standard.
2. **Analyse von Formellogik:** Wenn Sie prüfen müssen, wie sich eine Änderung des Steuersatzes in Zelle `B2` auf den Nettogewinn in `G48` auswirkt, verwenden Sie **XLSX**. CSV zerstört Formeln und behält nur statische Zahlen.
3. **Präsentationsdokumente:** Kommerzielle Angebote, Anleitungen und Verträge erfordern Titelseiten, stilistische Formatierung und Logos – dafür ist **DOCX** vorgesehen.
4. **Unstrukturiertes Wissen:** Artikel, wissenschaftliche Arbeiten und Anleitungen lassen sich nicht ohne Verlust semantischer Zusammenhänge in Tabellen reduzieren – dafür wird **Markdown** verwendet.
---
## 8. Programmatische Automatisierung: Arbeit mit CSV in Python und TypeScript
In produktiven AI-Agenten erfolgt die Interaktion mit CSV über schnelle Bibliotheken, die Überlastungen des Arbeitsspeichers verhindern.
:::tabs
@tab Python (Pandas & Streaming)
```python
import pandas as pd
# 1. Швидке зчитування та фільтрація великого датасету
df = pd.read_csv("clients.csv", encoding="utf-8")
# Очищення від порожніх записів та фільтрація
df_cleaned = df.dropna(subset=["email"]).copy()
df_cleaned["status"] = "Active"
# 2. Потокова обробка великих файлів (>1 ГБ) частинами
chunk_size = 5000
for chunk in pd.read_csv("massive_dataset.csv", chunksize=chunk_size):
# Передача chunk у модель для пакетної класифікації
processed_chunk = chunk[chunk["revenue"] > 10000]
processed_chunk.to_csv("filtered_data.csv", mode="a", header=False, index=False)
print("Обробка успішно завершена.")
```
@tab TypeScript (Papaparse & Node.js)
```typescript
import Papa from 'papaparse';
import * as fs from 'fs';
interface ClientRecord {
company: string;
country: string;
employees: number;
priority?: string;
}
// Зчитування та парсинг файлу
const fileContent = fs.readFileSync('companies.csv', 'utf8');
Papa.parse(fileContent, {
header: true,
dynamicTyping: true,
skipEmptyLines: true,
complete: (results) => {
// Збагачення кожного рядка через AI-сервіс
const enriched = results.data.map(row => ({
...row,
priority: row.employees > 100 ? 'High' : 'Standard'
}));
// Зворотна серіалізація в CSV
const csvOutput = Papa.unparse(enriched);
fs.writeFileSync('companies_enriched.csv', csvOutput, 'utf8');
}
});
```
:::
---
## 9. Fertige Bibliothek von Master-Prompts für die Arbeit mit CSV
Verwenden Sie diese fertigen Engineering-Vorlagen für die Arbeit mit Sprachmodellen, ohne Zeilen oder Struktur zu verlieren.
### Prompt zur Generierung einer neuen Datenbank von Grund auf
```markdown
Дій як провідний дата-аналітик. Згенеруй реалістичний синтетичний датасет у форматі CSV.
Тема: [Вкажіть тему, наприклад: Каталог AI-інструментів для маркетингу 2026]
Обсяг: Рівно 25 унікальних записів.
Вимоги до структури:
- Стовпці: Tool_Name, Category, Pricing_Model, Target_Audience, Key_Feature, URL_Slug
- Перший рядок — обов'язкові заголовки англійською мовою без пробілів.
- Один рядок відповідає рівно одному інструменту.
- Якщо опис містить коми, обов'язково бери значення в подвійні лапки.
- Виведи ТІЛЬКИ чистий сирий код CSV усередині блоку ```csv. Kein einleitender oder abschließender Text.
```
### Промпт для очищення та збагачення завантаженої таблиці
```markdown
Analysiere die hochgeladene CSV-Datei. Deine Aufgabe ist ein Audit und eine Datenanreicherung.
Verarbeitungsanweisungen:
1. Entferne vollständige Zeilen-Duplikate.
2. Standardisiere die Spalte Country gemäß internationalen Namensstandards.
3. Füge eine neue Spalte "Segment" hinzu:
- "Enterprise", wenn Employees > 250
- "Mid-Market", wenn Employees zwischen 50 und 250
- "SMB", wenn Employees < 50
4. Füge eine Spalte "Action_Plan" mit einer kurzen Empfehlung für den Manager hinzu (max. 10 Wörter).
5. Lösche nicht und ändere nicht die Reihenfolge der ursprünglichen Spalten.
Gib das Ergebnis als vollständige CSV-Datei zum Download zurück.
```
---
## 10. Abschließende Validierungs-Checkliste und Formatwahl-Spickzettel
Führen Sie eine Express-Validierung durch, bevor Sie eine generierte CSV-Datei in ein CRM hochladen oder an ein Analysesystem senden.
### Checkliste zur Prüfung der CSV-Qualität
- [ ] **Spaltenintegrität:** Die Anzahl der Kommas in jeder Zeile stimmt mit der Anzahl der Spalten in der Kopfzeile überein.
- [ ] **Korrekte Maskierung:** Alle Textfragmente, die Kommas oder Zeilenumbrüche enthalten, sind in doppelte Anführungszeichen `" "` eingeschlossen.
- [ ] **Keine überflüssigen Einrückungen:** Es gibt keine leeren Trennzeilen am Anfang, innerhalb oder am Ende der Datei.
- [ ] **Dateikodierung:** Die Datei ist im UTF-8-Format gespeichert (für Excel wurde ggf. die Anwesenheit von BOM überprüft).
- [ ] **Homogenität der Formate:** Daten haben einen einheitlichen Standard (`YYYY-MM-DD`), Dezimalzahlen sind mit Punkt formatiert.
### Spickzettel zur schnellen Auswahl
- Benötigen Sie reine Daten für Massenverarbeitung, Filterung oder Code $\rightarrow$ **CSV**.
- Benötigen Sie eine interaktive Tabelle mit Formeln, Diagrammen und Blättern $\rightarrow$ **XLSX**.
- Benötigen Sie mehrstufige verschachtelte Strukturen für Entwickler $\rightarrow$ **JSON**.
- Benötigen Sie ein formatiertes Dokument für Kunden und Management $\rightarrow$ **DOCX**.