# Формат CSV: повний посібник для автоматизації та роботи з ШІ
> Практичний посібник з використання формату CSV в AI-пайплайнах: специфікація RFC 4180, порівняння з XLSX і JSON, масове очищення та збагачення даних, кодинг на Python і готові промпти.
## 1. Що таке формат CSV: анатомія, специфікація RFC 4180 та будова даних
**CSV** (*Comma-Separated Values*) — це найпоширеніший у світі відкритий текстовий формат для зберігання та обміну двовимірними табличними даними. Його офіційну специфікацію зафіксовано в стандарті IETF RFC 4180.
За своєю суттю файл CSV є звичайним текстовим файлом без графічного оформлення: кожен рядок файлу відповідає одному рядку таблиці (запису), а значення колонок відокремлюються комами. Зазвичай перший рядок відводиться під заголовки стовпців.
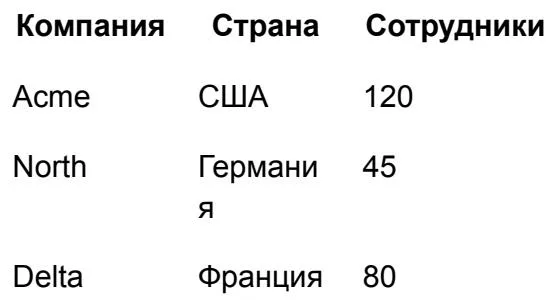
```csv
Компанія,Країна,Співробітники
Acme,США,120
North,Німеччина,45
Delta,Франція,80
```
### Фундаментальні правила форматування за RFC 4180
1. **Роздільники рядків:** Кожен запис розміщується на окремому рядку й завершується символом переводу рядка (`CRLF` або `LF`).
2. **Обов'язкові лапки:** Якщо значення комірки містить кому, символ нового рядка або подвійні лапки, усе значення має бути обов'язково взяте в подвійні лапки: `"Київ, Україна"`.
3. **Екранування лапок:** Внутрішні лапки всередині тексту екрануються подвоєнням: `"ТОВ ""Технології майбутнього"""`.
4. **Рівна кількість колонок:** Кожен рядок повинен містити точно таку саму кількість полів, що й перший рядок заголовків.
> [!NOTE]
> CSV зберігає виключно чисті значення. У ньому відсутня інформація про шрифти, кольори комірок, ширину колонок або формули. Саме ця простота перетворює CSV на універсальний міст між ШІ-моделями, базами даних і бізнес-сервісами.
---
## 2. Чому CSV є найефективнішим форматом для LLM та ШІ-агентів
Сучасні великі мовні моделі (GPT-4o, Claude 3.5 Sonnet, Gemini 1.5 Pro) однаково успішно сприймають як CSV, так і XLSX. Проте в інженерних пайплайнах та агентних системах саме CSV є стандартом за замовчуванням.
```mermaid
flowchart LR
A["Сирий неструктурований текст
(Відгуки, ліди, описи)"] --> B["LLM / AI-агент
(Парсинг сутностей)"]
B -->|Генерація плоского потоку| C["Потік даних CSV
(Мінімальна витрата токенів)"]
C --> D["Бази даних SQL / NoSQL
(Миттєвий bulk import)"]
C --> E["CRM / BI Дашборди
(HubSpot, Tableau, Sheets)"]
```
### Головні переваги CSV для систем штучного інтелекту
- **Екстремальна економія токенів:** На відміну від формату XLSX (який є запакованим ZIP-архівом із десятків XML-файлів) чи JSON (де кожна назва поля дублюється для кожного об'єкта), CSV передає назви полів рівно один раз у шапці.
- **Низьке когнітивне навантаження на контекст:** Моделі значно легше орієнтуватися в таблиці без зайвого XML-шуму, службових тегів та метаданих стилів.
- **Підтримка потокової передачі (Streaming):** ШІ може генерувати CSV-рядок за рядком у режимі реального часу, дозволяючи обробляти мільйони записів частинами (chunks) без завантаження всього документа в пам'ять.
- **Ідеальна сумісність із Code Interpreter:** Середовища виконання коду в ChatGPT або Claude миттєво зчитують CSV в одну строчку через `pandas.read_csv()`.
---
## 3. Порівняльний аналіз: CSV проти XLSX та JSON
Вибір формату залежить від того, чи потрібні вам виключно «голі» дані, чи необхідна повноцінна робоча книга з формулами або складна вкладена ієрархія.
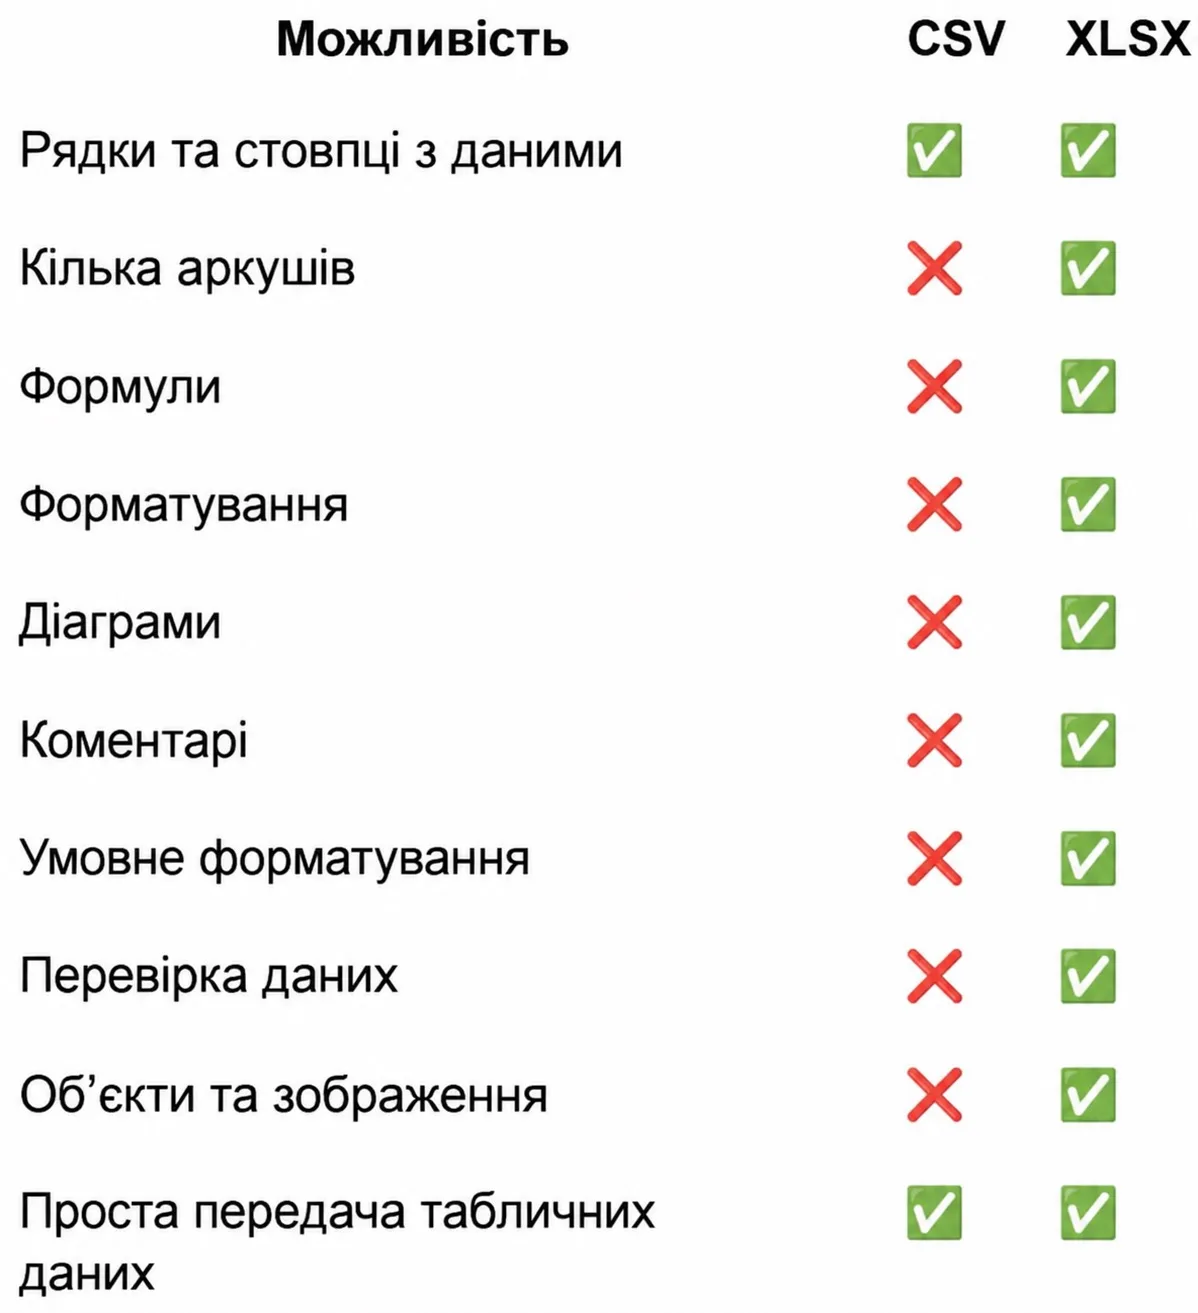
| Можливість та критерій | CSV | XLSX (Excel) | JSON |
| :--- | :--- | :--- | :--- |
| **Рядки та стовпці з даними** | ✓ Так | ✓ Так | Потрібна нормалізація |
| **Кілька іменованих аркушів** | ✗ Ні (лише 1 аркуш) | ✓ Так | ✓ Через вкладені масиви |
| **Обчислювальні формули** | ✗ Ні | ✓ Так (живі формули) | ✗ Ні |
| **Оформлення та стилізація** | ✗ Ні | ✓ Так (кольори, шрифти) | ✗ Ні |
| **Вкладені ієрархічні структури** | ✗ Складно (плоскі дані) | ✗ Обмежено | ✓ Ідеально (деревоподібні) |
| **Економія токенів для ШІ** | ⭐ Найвища | ⚠️ Низька (XML-накладні витрати) | 🟡 Середня (повтор ключів) |
| **Прямий імпорт у CRM / SQL** | ✓ В один клік | ⚠️ Потребує конвертації | ⚠️ Потребує мапінгу |
> [!TIP]
> Якщо ваша мета — передати масив товарів для класифікації або вивантажити базу лідів для розсилки, використовуйте CSV. Якщо ж потрібно надати фінансову модель інвестору з підсумковими розрахунками — залишайте XLSX.
---
## 4. Типові пастки синтаксису CSV: роздільники, лапки та кодування UTF-8
Хоча формат здається примітивним, на практиці понад 70% помилок автоматизації виникають через три технічні нюанси.
### Конфлікт коми та крапки з комою (Локалі Excel)
У країнах Європи та пострадянського простору десятковий роздільник у числах — це кома (`12,50`). Через це європейські версії Microsoft Excel за замовчуванням експортують CSV, використовуючи як роздільник стовпців крапку з комою (`;`), а не кому (`,`).
- Якщо ШІ очікує кому, а отримує крапку з комою — вся таблиця зливається в один гігантський стовпець.
- Завжди явно вказуйте системі роздільник: *«Використовуй стандартну кому як роздільник стовпців»*.
### Перенесення рядків усередині комірки
Якщо комірка з описом містить кілька абзаців, некоректний парсер сприйме кожен абзац як новий запис таблиці. Відповідно до стандарту RFC 4180, такі поля зобов'язані бути замкнені в подвійні лапки:
```csv
ID,Назва,Опис
101,Ноутбук,"Потужний процесор.
Гарантія 24 місяці."
```
### Пастка кодування UTF-8 та маркер BOM
Під час відкриття CSV-файлу з кирилицею у програмі Excel замість тексту часто з'являються «кракозябри». Причина — відсутність сигнатури **BOM** (*Byte Order Mark* — байти `EF BB BF`).
- Для імпорту в сучасні бази даних і ШІ-сервіси використовуйте чистий **UTF-8 without BOM**.
- Для гарантованого відкриття у десктопному Microsoft Excel на Windows зберігайте як **UTF-8 with BOM**.
---
## 5. Підготовка CSV для ШІ: правила чистоти та гігієни даних
Чим якісніше оформлений вхідний CSV-файл, тим точнішими будуть аналітичні висновки та трансформації мовної моделі.
```mermaid
flowchart TD
subgraph Hygiene_Rules["5 Золотих Правил Гігієни CSV"]
R1["1. Семантичні назви стовпців
(Company замість Column_1)"]
R2["2. Атомарність полів
(Окремо Name та Email)"]
R3["3. Безперервність масиву
(Жодних порожніх розділових рядків)"]
R4["4. Канонічні типи даних
(ISO дати YYYY-MM-DD, чисті числа)"]
R5["5. Один рядок — один об'єкт
(Заборона злиття різних сутностей)"]
end
```
### До та після санітарної обробки
:::tabs
@tab Засмічений CSV (Погано)
```csv
Звіт за травень 2026,,,
Компанія,Інформація,Сума
ТОВ Вектор,"Київ, Іван, тел: 0501112233",5000 грн
ПП Альфа,Одеса; Петро,12000 $
```
*Проблеми:* Зайвий рядок заголовка, порожній розділовий рядок, змішані валюти, змішана контактна інформація в одній колонці.
@tab Очищений CSV (Ідеально для ШІ)
```csv
company_name,city,contact_person,phone,amount,currency
ТОВ Вектор,Київ,Іван,+380501112233,5000,UAH
ПП Альфа,Одеса,Петро,+380502223344,12000,USD
```
*Переваги:* Атомарні поля, чисті числа, стандартизовані коди валют, миттєве читання алгоритмами.
:::
---
## 6. Масова обробка даних: очищення, збагачення та класифікація через ШІ
Найбільшу цінність CSV демонструє під час виконання масових трансформацій через ChatGPT Advanced Data Analysis або Claude Code.
### Головні сценарії масової автоматизації
1. **Дедуплікація та злиття баз:** Виявлення неявних дублікатів (наприклад: *«Google LLC»* та *«Гугл Україна»*), очищення від невалідних email-адрес.
2. **Семантичне збагачення (Enrichment):** Додавання до наявного списку компаній оцінки їхнього масштабу, індустрії за КВЕД або посилання на офіційний сайт.
3. **Аналіз тональності та категорізація:** Масовий аналіз 10 000 текстових відгуків клієнтів із проставленням тегів `Sentiment` (*Positive/Neutral/Negative*) та `Issue_Type` (*Delivery/Billing/UX*).
4. **Нормалізація сутностей:** Приведення десятків різнобійних записів країн (*«USA», «U.S.», «United States», «США»*) до єдиного ISO-коду `US`.
---
## 7. Коли CSV категорично НЕ підходить: обмеження та альтернативи
CSV є вузькоспеціалізованим інструментом. Спроба використовувати його не за призначенням руйнує робочі процеси.
### Чотири бар'єри застосування CSV
1. **Багаторівневі зв'язки та списки:** Якщо один користувач має 5 адрес доставки, 3 банківські картки та 20 замовлених товарів, спроба втиснути це в один рядок CSV спричинить або дублювання даних, або нечитабельні комірки. Для таких задач стандартом є **JSON**.
2. **Аналіз формульної логіки:** Якщо вам потрібно перевірити, як зміна ставки податку в комірці `B2` впливає на чистий прибуток у `G48`, використовуйте **XLSX**. CSV знищує формули, залишаючи лише зафіксовані числа.
3. **Презентаційні документи:** Комерційні пропозиції, інструкції та договори вимагають титульних аркушів, стильової розмітки та логотипів — для них призначений **DOCX**.
4. **Неструктуровані знання:** Статті, наукові роботи та інструкції не можна зводити до таблиць без втрати смислових зв'язків — для них використовується **Markdown**.
---
## 8. Програмна автоматизація: робота з CSV на Python та TypeScript
У виробничих AI-агентах взаємодія з CSV здійснюється через швидкі бібліотеки, які запобігають переповненню оперативної пам'яті.
:::tabs
@tab Python (Pandas & Streaming)
```python
import pandas as pd
# 1. Швидке зчитування та фільтрація великого датасету
df = pd.read_csv("clients.csv", encoding="utf-8")
# Очищення від порожніх записів та фільтрація
df_cleaned = df.dropna(subset=["email"]).copy()
df_cleaned["status"] = "Active"
# 2. Потокова обробка великих файлів (>1 ГБ) частинами
chunk_size = 5000
for chunk in pd.read_csv("massive_dataset.csv", chunksize=chunk_size):
# Передача chunk у модель для пакетної класифікації
processed_chunk = chunk[chunk["revenue"] > 10000]
processed_chunk.to_csv("filtered_data.csv", mode="a", header=False, index=False)
print("Обробка успішно завершена.")
```
@tab TypeScript (Papaparse & Node.js)
```typescript
import Papa from 'papaparse';
import * as fs from 'fs';
interface ClientRecord {
company: string;
country: string;
employees: number;
priority?: string;
}
// Зчитування та парсинг файлу
const fileContent = fs.readFileSync('companies.csv', 'utf8');
Papa.parse(fileContent, {
header: true,
dynamicTyping: true,
skipEmptyLines: true,
complete: (results) => {
// Збагачення кожного рядка через AI-сервіс
const enriched = results.data.map(row => ({
...row,
priority: row.employees > 100 ? 'High' : 'Standard'
}));
// Зворотна серіалізація в CSV
const csvOutput = Papa.unparse(enriched);
fs.writeFileSync('companies_enriched.csv', csvOutput, 'utf8');
}
});
```
:::
---
## 9. Готова бібліотека майстер-промптів для роботи з CSV
Використовуйте ці готові інженерні шаблони для роботи з мовними моделями без втрати рядків і структури.
### Промпт для генерації нової бази з нуля
```markdown
Дій як провідний дата-аналітик. Згенеруй реалістичний синтетичний датасет у форматі CSV.
Тема: [Вкажіть тему, наприклад: Каталог AI-інструментів для маркетингу 2026]
Обсяг: Рівно 25 унікальних записів.
Вимоги до структури:
- Стовпці: Tool_Name, Category, Pricing_Model, Target_Audience, Key_Feature, URL_Slug
- Перший рядок — обов'язкові заголовки англійською мовою без пробілів.
- Один рядок відповідає рівно одному інструменту.
- Якщо опис містить коми, обов'язково бери значення в подвійні лапки.
- Виведи ТІЛЬКИ чистий сирий код CSV усередині блоку ```csv. Жодного вступного або підсумкового тексту.
```
### Промпт для очищення та збагачення завантаженої таблиці
```markdown
Проаналізуй завантажений файл CSV. Твоє завдання — провести аудит та збагачення даних.
Інструкції з обробки:
1. Видали повні рядки-дублікати.
2. Стандартизуй стовпець Country відповідно до міжнародного стандарту назв.
3. Додай новий стовпець "Segment":
- "Enterprise", якщо Employees > 250
- "Mid-Market", якщо Employees від 50 до 250
- "SMB", якщо Employees < 50
4. Додай стовпець "Action_Plan" із короткою рекомендацією для менеджера (до 10 слів).
5. Не видаляй і не змінюй порядок вихідних стовпців.
Поверни результат у вигляді повноцінного CSV-файлу для завантаження.
```
---
## 10. Підсумковий чек-лист валідації та шпаргалка вибору формату
Перед тим як завантажити згенерований CSV-файл у CRM або відправити в аналітичну систему, проведіть експрес-валідацію.
### Чек-лист перевірки якості CSV
- [ ] **Цілісність колонок:** Кількість ком у кожному рядку збігається з кількістю колонок у першому рядку заголовків.
- [ ] **Коректне екранування:** Усі текстові фрагменти, що містять коми або переноси рядків, закриті в подвійні лапки `" "`.
- [ ] **Відсутність зайвих відступів:** Немає порожніх розділових рядків на початку, всередині чи в кінці файлу.
- [ ] **Кодування файлу:** Файл збережено у форматі UTF-8 (для Excel перевірено наявність BOM за потреби).
- [ ] **Однорідність форматів:** Дати мають єдиний стандарт (`YYYY-MM-DD`), десяткові дроби оформлені через крапку.
### Шпаргалка швидкого вибору
- Потрібні чисті дані для масової обробки, фільтрації чи коду $\rightarrow$ **CSV**.
- Потрібна інтерактивна таблиця з формулами, діаграмами та аркушами $\rightarrow$ **XLSX**.
- Потрібні багаторівневі вкладені структури для розробників $\rightarrow$ **JSON**.
- Потрібен відформатований документ для клієнтів і керівництва $\rightarrow$ **DOCX**.