# Формат CSV: полное руководство для автоматизации и работы с ИИ
> Практическое руководство по использованию формата CSV в AI-пайплайнах: спецификация RFC 4180, сравнение с XLSX и JSON, массовая очистка и обогащение данных, автоматизация на Python и готовые промпты.
## 1. Что такое формат CSV: анатомия, спецификация RFC 4180 и структура данных
**CSV** (*Comma-Separated Values*) — это самый распространенный в мире открытый текстовый формат для хранения и обмена двумерными табличными данными. Его официальная спецификация закреплена в международном стандарте IETF RFC 4180.
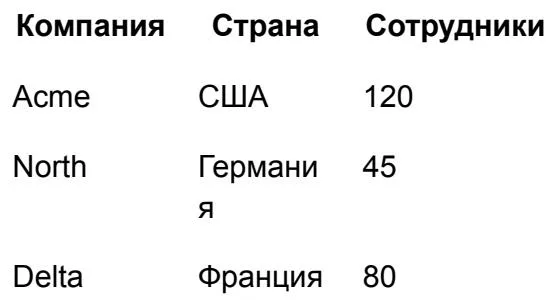
По своей сути файл CSV представляет собой обычный текстовый файл без графического оформления: каждая строка файла соответствует одной строке таблицы (записи), а значения ячеек разделяются запятыми. Как правило, самая первая строка отводится под заголовки столбцов.
```csv
Компания,Страна,Сотрудники
Acme,США,120
North,Германия,45
Delta,Франция,80
```
### Базовые правила форматирования по RFC 4180
1. **Разделители строк:** Каждая запись располагается на новой строке и завершается символом перевода строки (`CRLF` или `LF`).
2. **Обязательные кавычки:** Если значение ячейки содержит запятую, перевод строки или двойные кавычки, всё значение обязательно обрамляется двойными кавычками: `"Киев, Украина"`.
3. **Экранирование кавычек:** Внутренние кавычки в тексте экранируются удвоением: `"ООО ""Технологии будущего"""`.
4. **Равное число столбцов:** Каждая строка таблицы должна содержать ровно столько же полей, сколько задано в первой строке заголовков.
> [!NOTE]
> CSV хранит исключительно чистые значения данных. В нем нет информации о шрифтах, цветах ячеек, ширине колонок или формулах. Именно эта простота делает CSV универсальным мостом между ИИ-моделями, базами данных и сервисами аналитики.
---
## 2. Почему CSV — самый эффективный формат для LLM и ИИ-агентов
Современные большие языковые модели (GPT-4o, Claude 3.5 Sonnet, Gemini 1.5 Pro) уверенно работают как с CSV, так и с XLSX. Однако в инженерных пайплайнах и агентных системах именно CSV является форматом по умолчанию.
```mermaid
flowchart LR
A["Сырой неструктурированный текст
(Отзывы, лиды, тикеты)"] --> B["LLM / ИИ-агент
(Парсинг сущностей)"]
B -->|Генерация плоского потока| C["Поток данных CSV
(Минимальный расход токенов)"]
C --> D["Базы данных SQL / NoSQL
(Быстрый bulk import)"]
C --> E["CRM / BI Дашборды
(HubSpot, Tableau, Sheets)"]
```
### Главные преимущества CSV для систем искусственного интеллекта
- **Колоссальная экономия токенов:** В отличие от формата XLSX (который представляет собой упакованный ZIP-архив из десятков XML-файлов) или JSON (где названия ключей дублируются для каждой записи), CSV определяет названия полей ровно один раз в шапке.
- **Минимальная когнитивная нагрузка на контекст:** Модели намного легче ориентироваться в таблице без XML-шума, тегов и метаданных стилей.
- **Поддержка потоковой передачи (Streaming):** ИИ может генерировать CSV строка за строкой в реальном времени, что позволяет обрабатывать большие объемы данных частями (chunks) без перегрузки памяти.
- **Идеальная совместимость с Code Interpreter:** Среды выполнения кода в ChatGPT и Claude считывают CSV в одну строчку через `pandas.read_csv()`.
---
## 3. Сравнительный анализ: CSV против XLSX и JSON
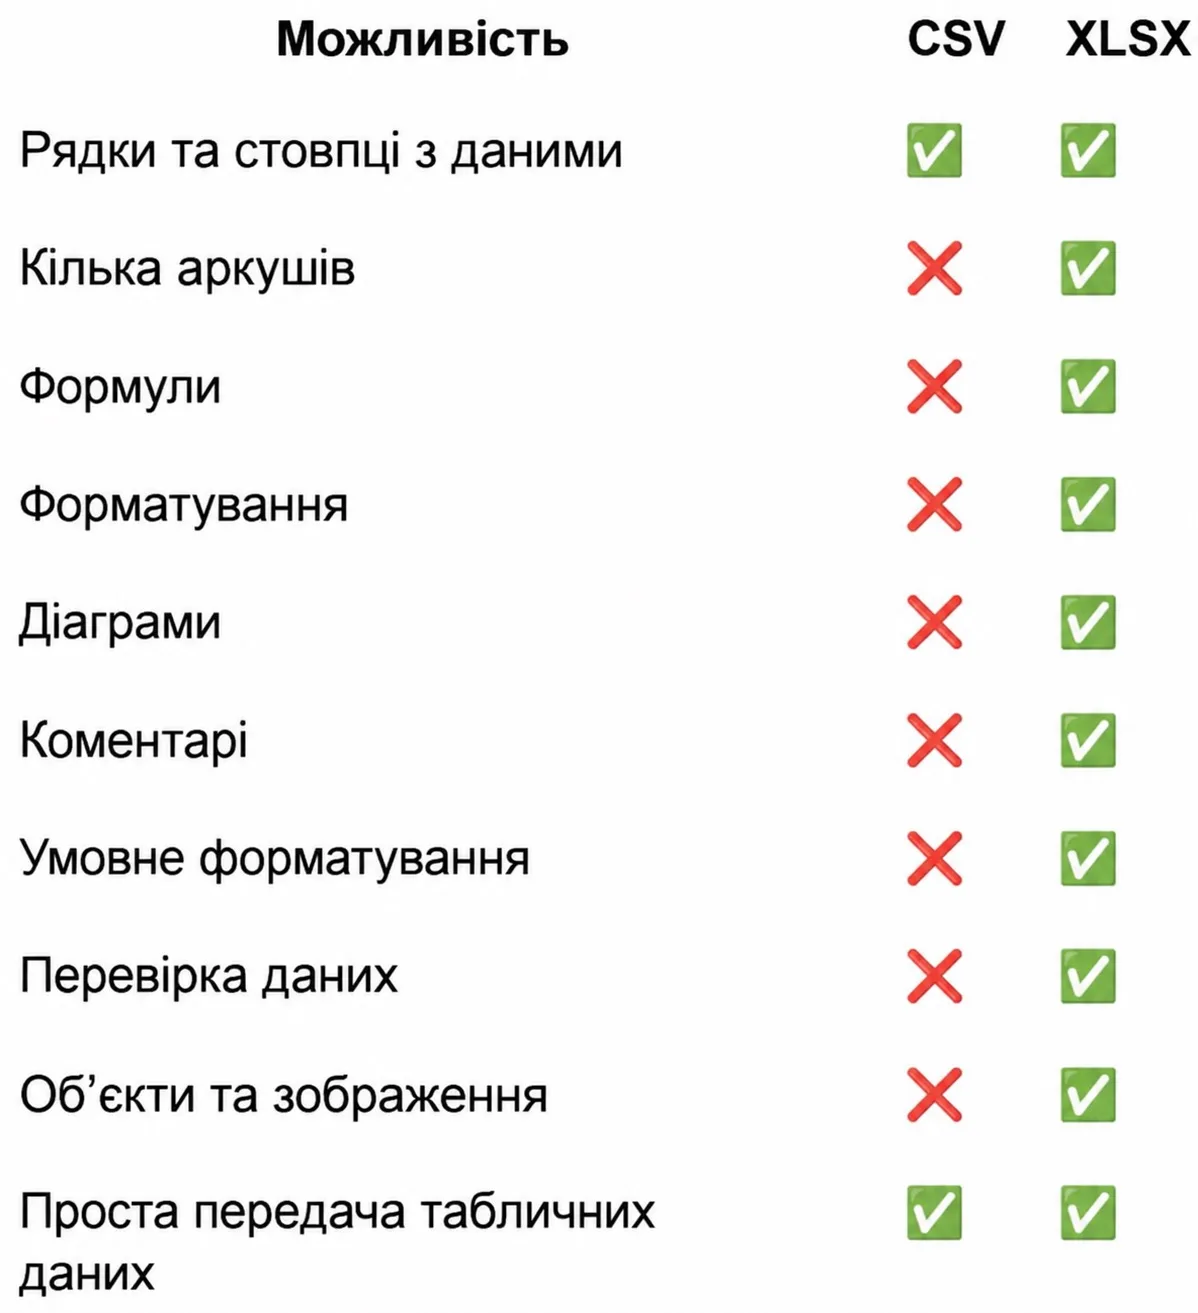
Выбор формата зависит от того, нужны ли вам чистые табличные данные, полноценная рабочая книга с формулами или сложная древовидная структура.
| Возможность и критерий | CSV | XLSX (Excel) | JSON |
| :--- | :--- | :--- | :--- |
| **Строки и столбцы с данными** | ✓ Да | ✓ Да | Требуется нормализация |
| **Несколько именованных листов** | ✗ Нет (только 1 лист) | ✓ Да | ✓ Через вложенные массивы |
| **Вычислительные формулы** | ✗ Нет | ✓ Да (живые формулы) | ✗ Нет |
| **Оформление и стилизация** | ✗ Нет | ✓ Да (цвета, шрифты) | ✗ Нет |
| **Вложенные иерархические структуры** | ✗ Плохо (плоские данные) | ✗ Ограниченно | ✓ Идеально (деревья объектов) |
| **Экономия токенов для ИИ** | ⭐ Максимальная | ⚠️ Низкая (XML-накладные расходы) | 🟡 Средняя (повтор ключей) |
| **Прямой импорт в CRM / SQL** | ✓ В один клик | ⚠️ Требует конвертации | ⚠️ Требует маппинга |
> [!TIP]
> Используйте CSV, когда ваша цель — массовая трансформация данных, табличная классификация или загрузка в базу. Оставляйте XLSX только тогда, когда файл предназначен для людей, которым необходимы формулы и визуальные диаграммы.
---
## 4. Типичные ловушки синтаксиса CSV: разделители, кавычки и кодировка UTF-8
Несмотря на кажущуюся простоту, более 70% сбоев автоматизации происходят из-за трех технических нюансов.
### Конфликт запятой и точки с запятой (Региональные настройки Excel)
В странах Европы и СНГ десятичным разделителем в числах является запятая (`12,50`). Поэтому европейские версии Microsoft Excel по умолчанию экспортируют CSV с точкой с запятой (`;`) в качестве разделителя колонок.
- Если ИИ ожидает запятые, а получает точки с запятой — вся таблица склеивается в одну гигантскую колонку.
- Всегда явно указывайте в промпте разделитель: *«Используй стандартную запятую в качестве разделителя столбцов»*.
### Переносы строк внутри ячейки
Если ячейка с описанием содержит несколько абзацев, некорректный парсер воспримет каждый абзац как новую строку таблицы. По стандарту RFC 4180 такие поля обязаны быть заключены в двойные кавычки:
```csv
ID,Название,Описание
101,Ноутбук,"Мощный процессор.
Гарантия 24 месяца."
```
### Кодировка UTF-8 и сигнатура BOM
При открытии CSV с кириллицей в Excel на Windows вместо текста нередко отображаются нечитаемые символы. Причина — отсутствие сигнатуры **BOM** (*Byte Order Mark* — байты `EF BB BF`).
- Для современных баз данных и облачных ИИ-сервисов используйте чистый **UTF-8 without BOM**.
- Для гарантированного открытия в десктопном Microsoft Excel на Windows сохраняйте как **UTF-8 with BOM**.
---
## 5. Подготовка CSV для ИИ: правила чистоты и гигиены данных
Чем аккуратнее оформлен входной файл CSV, тем точнее будут аналитические выводы языковой модели.
```mermaid
flowchart TD
subgraph Hygiene_Rules["5 Золотых Правил Гигиены CSV"]
R1["1. Понятные заголовки столбцов
('company_name' вместо 'Col1')"]
R2["2. Атомарность полей
(Отдельно 'first_name' и 'email')"]
R3["3. Непрерывность массива
(Никаких пустых декоративных строк)"]
R4["4. Канонические типы данных
(ISO даты YYYY-MM-DD, чистые числа)"]
R5["5. Одна строка — один объект
(Строгая 2D-нормализация)"]
end
```
### До и после санитарной обработки
:::tabs
@tab Замусоренный CSV (Плохо)
```csv
Отчет за май 2026,,,
Компания,Контакты,Сумма
ООО Вектор,"Киев, Иван, тел: +380501112233",5000 грн
ЧП Альфа,Одесса; Петр,12000 $
```
*Проблемы:* Лишняя строка заголовка, пустая строка-разделитель, склеенные контакты, смешанные валюты.
@tab Очищенный CSV (Идеально для ИИ)
```csv
company_name,city,contact_name,phone,amount,currency
ООО Вектор,Киев,Иван,+380501112233,5000,UAH
ЧП Альфа,Одесса,Петр,+380502223344,12000,USD
```
*Преимущества:* Атомарные поля, чистые числа, стандартизированные коды валют, мгновенный парсинг алгоритмами.
:::
---
## 6. Массовая обработка данных: очистка, обогащение и классификация через ИИ
Наибольшую отдачу CSV дает при выполнении пакетных операций через ChatGPT Advanced Data Analysis или Claude Code.
### Ключевые сценарии автоматизации
1. **Дедупликация и слияние баз:** Поиск неявных дубликатов (например: *«Google LLC»* и *«Гугл Украина»*), фильтрация невалидных email-адресов.
2. **Семантическое обогащение (Enrichment):** Добавление к списку компаний оценки масштаба бизнеса, отрасли по классификатору или ссылки на сайт.
3. **Анализ тональности и разметка:** Пакетный анализ 10 000 отзывов клиентов с простановкой меток `Sentiment` (*Positive/Neutral/Negative*) и `Category` (*Delivery/Billing/Bug*).
4. **Нормализация сущностей:** Приведение разнородных записей стран (*«USA», «U.S.», «United States», «США»*) к единому стандарту `US`.
---
## 7. Когда CSV категорически НЕ подходит: ограничения и альтернативы
CSV — узкоспециализированный инструмент. Попытка использовать его не по назначению приводит к потере данных.
### Четыре барьера применения CSV
1. **Многоуровневые вложенные структуры:** Хранение клиента с 5 адресами доставки, 3 картами и 20 позициями заказов в плоской строке CSV порождает дублирование данных. Для таких структур стандартом является **JSON**.
2. **Анализ формул и связей:** Если требуется проверить, как изменение ставки налога в ячейке `B2` влияет на прибыль в `G48`, используйте **XLSX**. CSV стирает формулы, оставляя только числа.
3. **Презентационные документы:** Коммерческие предложения, регламенты и договоры требуют стилей, титульных листов и колонтитулов — для них предназначен **DOCX**.
4. **Неструктурированные тексты:** Статьи, аналитические записки и инструкции теряют связность при сведении в таблицы — для них используется **Markdown**.
---
## 8. Программная автоматизация: работа с CSV на Python и TypeScript
В автономных AI-агентах обработка CSV выполняется через оптимизированные библиотеки, исключающие утечки памяти.
:::tabs
@tab Python (Pandas & Streaming)
```python
import pandas as pd
# 1. Быстрое считывание и фильтрация датасета
df = pd.read_csv("clients.csv", encoding="utf-8")
# Очистка от пустых записей и добавление столбца
df_cleaned = df.dropna(subset=["email"]).copy()
df_cleaned["status"] = "Active"
# 2. Потоковая обработка больших файлов (>1 ГБ) частями
chunk_size = 5000
for chunk in pd.read_csv("massive_dataset.csv", chunksize=chunk_size):
# Пакетная классификация или фильтрация
processed_chunk = chunk[chunk["revenue"] > 10000]
processed_chunk.to_csv("filtered_data.csv", mode="a", header=False, index=False)
print("Пакетная обработка завершена.")
```
@tab TypeScript (Papaparse & Node.js)
```typescript
import Papa from 'papaparse';
import * as fs from 'fs';
interface CompanyRecord {
company: string;
country: string;
employees: number;
priority?: string;
}
// Потоковое чтение файла
const fileContent = fs.readFileSync('companies.csv', 'utf8');
Papa.parse(fileContent, {
header: true,
dynamicTyping: true,
skipEmptyLines: true,
complete: (results) => {
// Обогащение каждой строки через ИИ-логику
const enriched = results.data.map(row => ({
...row,
priority: row.employees > 100 ? 'High' : 'Standard'
}));
// Сериализация обратно в CSV
const csvOutput = Papa.unparse(enriched);
fs.writeFileSync('companies_enriched.csv', csvOutput, 'utf8');
}
});
```
:::
---
## 9. Готовая библиотека мастер-промптов для работы с CSV
Используйте эти проверенные шаблоны для работы с языковыми моделями без потери строк и повреждения структуры.
### Промпт для генерации датасета с нуля
```markdown
Действуй как ведущий дата-аналитик. Сгенерируй реалистичный синтетический датасет в формате RFC 4180 CSV.
Тема: [Укажите тему, например: Каталог AI-инструментов для маркетинга 2026]
Объем: Ровно 25 уникальных записей.
Требования к структуре:
- Столбцы: Tool_Name, Category, Pricing_Model, Target_Audience, Key_Feature, URL_Slug
- Первая строка — обязательные заголовки на английском языке без пробелов.
- Одна строка соответствует ровно одному инструменту.
- Если описание содержит запятые, обязательно заключай значение в двойные кавычки.
- Выведи ТОЛЬКО чистый сырой CSV внутри блока ```csv. Никакого вводного текста.
```
### Промпт для очистки и обогащения таблицы
```markdown
Проанализируй прикрепленный файл CSV. Твоя задача — провести аудит и обогащение данных.
Инструкции по обработке:
1. Удали полные строки-дубликаты.
2. Стандартизируй столбец Country в соответствии с международным стандартом названий.
3. Добавь новый столбец "Segment":
- "Enterprise", если Employees > 250
- "Mid-Market", если Employees от 50 до 250
- "SMB", если Employees < 50
4. Добавь столбец "Action_Plan" с короткой директивой для менеджера (до 10 слов).
5. Не удаляй и не меняй порядок исходных столбцов.
Верни результат в виде готового CSV-файла для скачивания.
```
---
## 10. Итоговый чек-лист валидации и шпаргалка выбора формата
Перед загрузкой созданного CSV-файла в CRM или хранилище данных проведите экспресс-проверку.
### Чек-лист проверки качества CSV
- [ ] **Целостность колонок:** Число разделителей в каждой строке совпадает с числом заголовков в первой строке.
- [ ] **Корректное экранирование:** Все текстовые фрагменты с запятыми или переводами строк заключены в кавычки `" "`.
- [ ] **Отсутствие мусорных строк:** Нет пустых строк-разделителей в начале, теле или конце файла.
- [ ] **Кодировка файла:** Файл сохранен в кодировке UTF-8 (для Excel проверено наличие BOM при необходимости).
- [ ] **Однородность типов данных:** Даты оформлены по ISO 8601 (`YYYY-MM-DD`), десятичные дроби записаны через точку.
### Шпаргалка быстрого выбора
- Чистые табличные данные для массовой обработки или скриптов $\rightarrow$ **CSV**.
- Интерактивная расчетная таблица с формулами, графиками и листами $\rightarrow$ **XLSX**.
- Древовидные вложенные структуры для API и разработчиков $\rightarrow$ **JSON**.
- Оформленный документ для чтения человеком, печати и архива $\rightarrow$ **DOCX**.